

Erklärung: Wie wählt die L1-Regularisierung automatisch Features aus?
Verstehen Sie den automatischen Merkmalsauswahlprozess, der durch die L1-Regularisierung (LASSO) durchgeführt wird.

Bei der Merkmalsauswahl handelt es sich um den Vorgang, aus einem gegebenen Satz von Merkmalen eine optimale Teilmenge von Merkmalen auszuwählen. Die optimale Teilmenge ist diejenige, die die Leistung des Modells bei der gegebenen Aufgabe maximiert.
Die Merkmalsauswahl kann manuell oder, genauer gesagt, explizit mittels Filter- oder Wrapping-Methoden erfolgen . Dabei werden Merkmale wiederholt hinzugefügt oder entfernt, basierend auf einem festen Metrikwert, der ihre Bedeutung für die Vorhersage bestimmt. Als Metriken können Informationsgewinn, Varianz oder Chi-Quadrat-Test dienen. Der Algorithmus entscheidet anhand eines festgelegten Schwellenwerts für die jeweilige Metrik, ob ein Merkmal akzeptiert oder verworfen wird. Wichtig ist, dass diese Methoden nicht Teil der Modelltrainingsphase sind, sondern im Vorfeld durchgeführt werden.
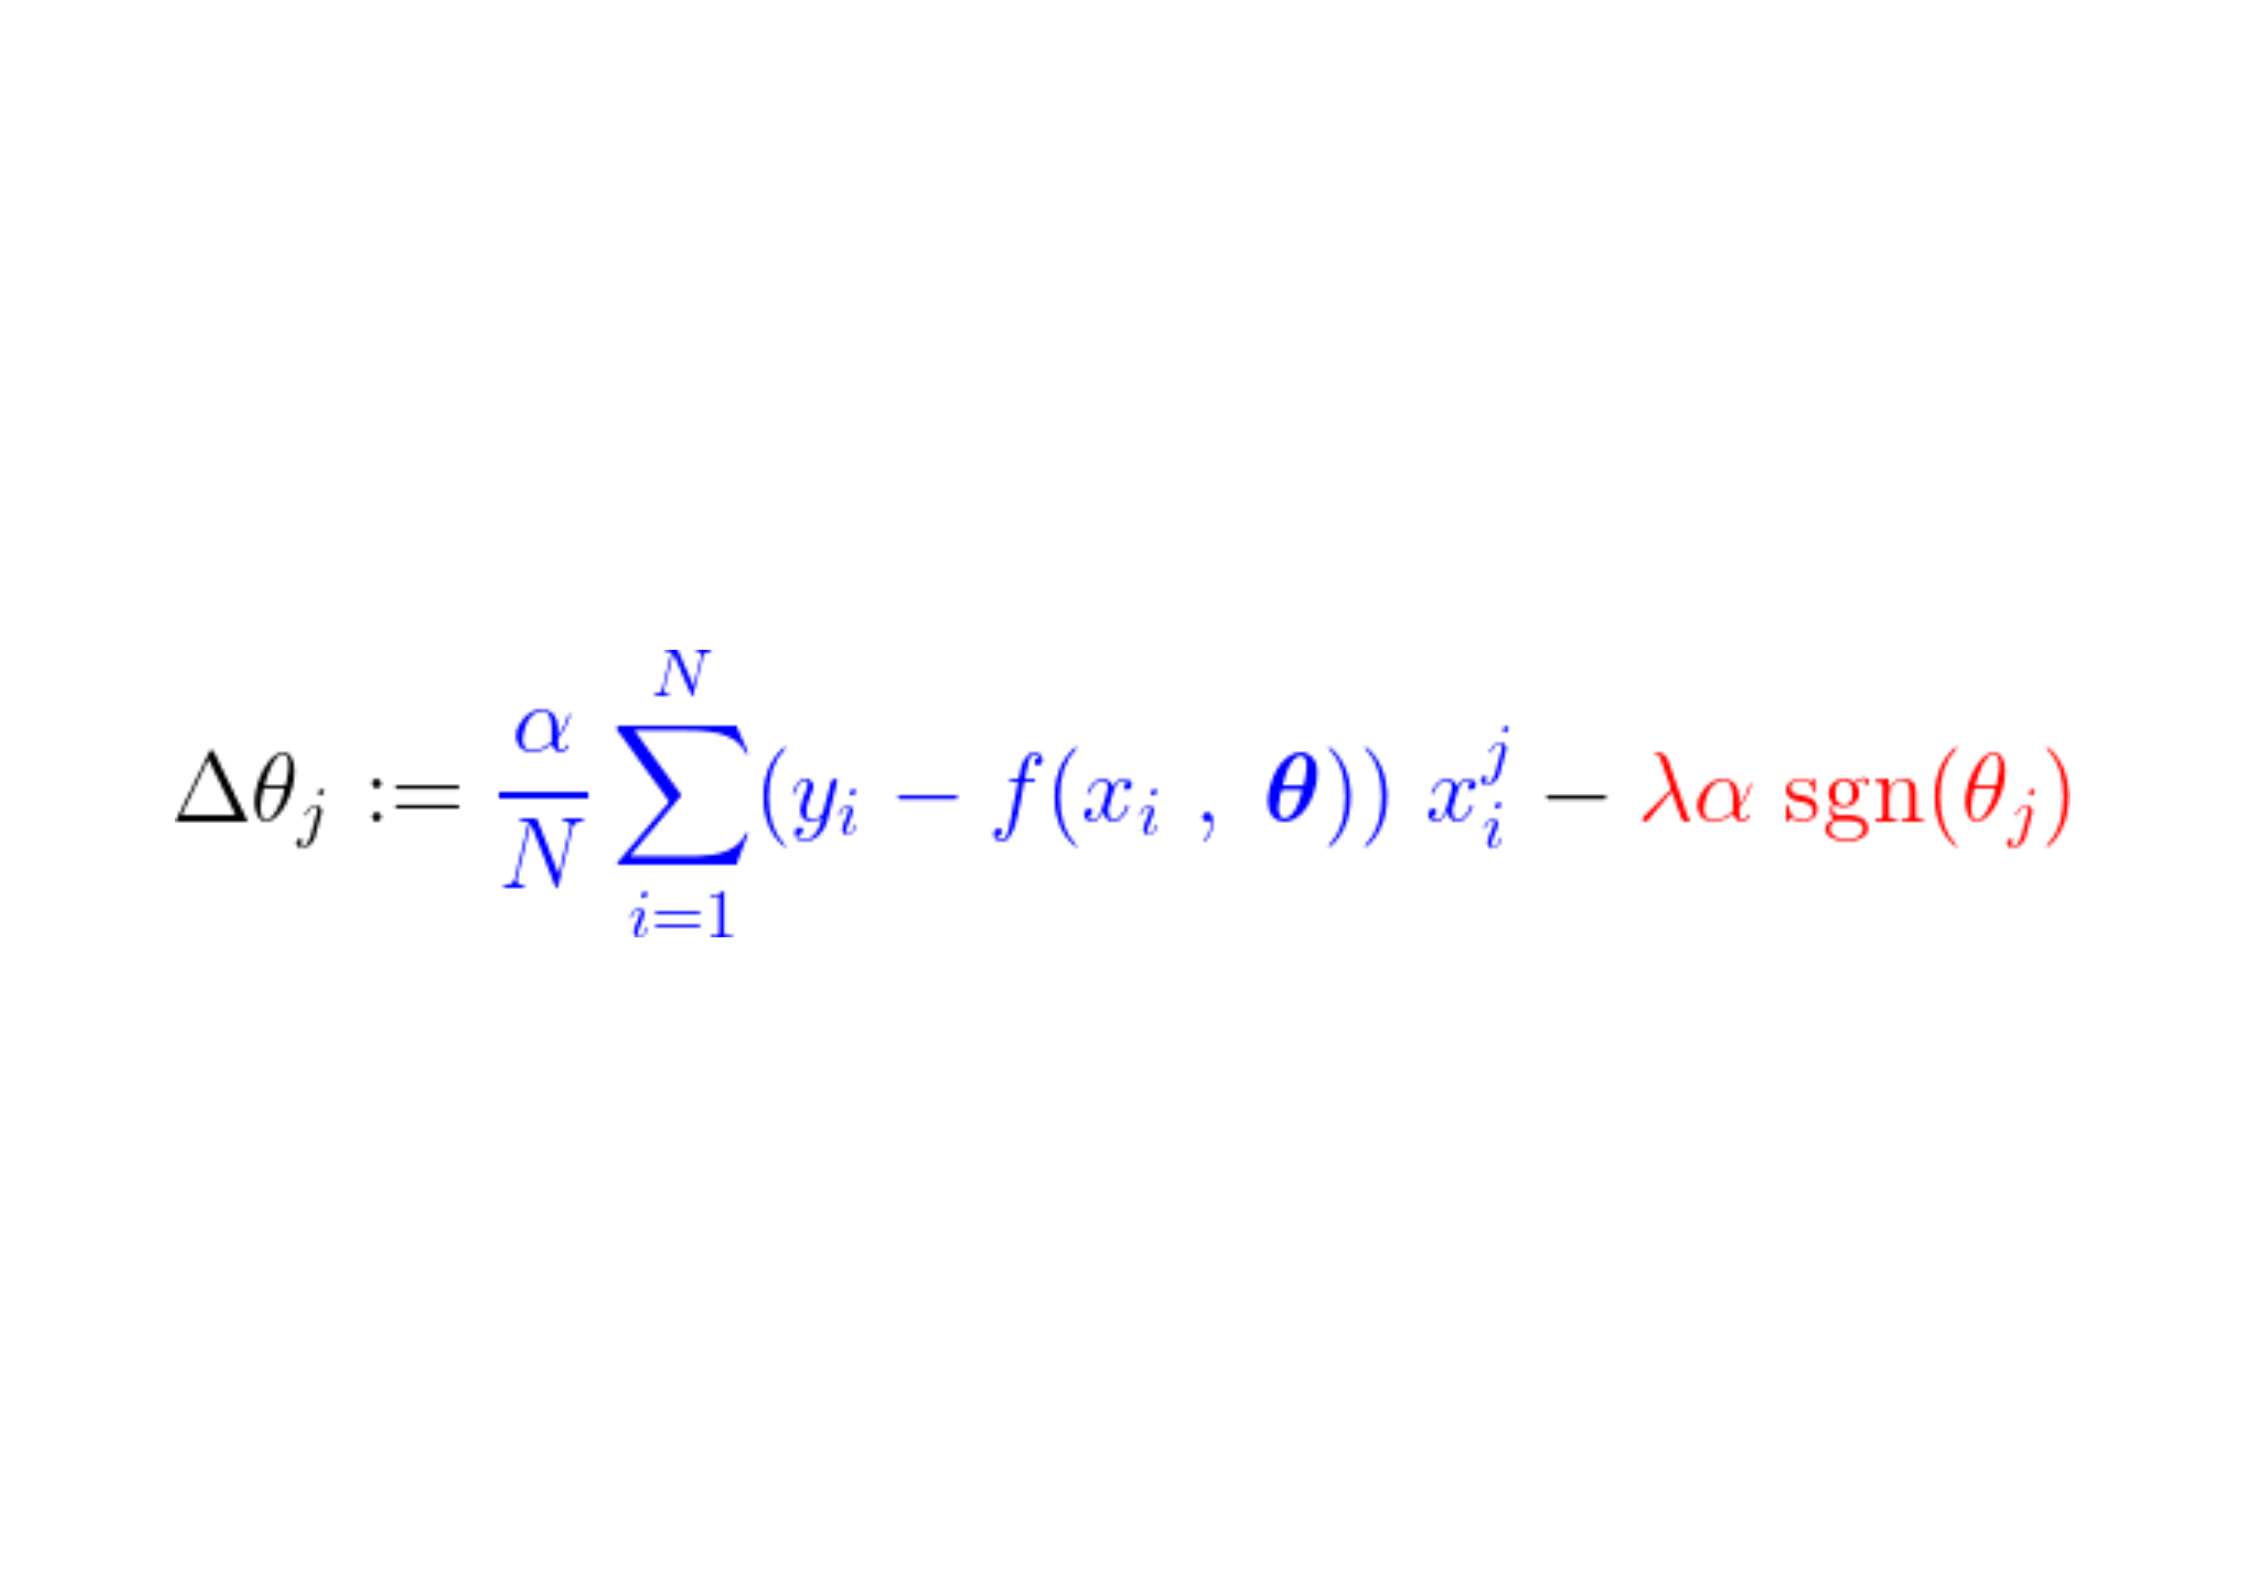
Eingebettete Methoden identifizieren Merkmale implizit, ohne vordefinierte Auswahlkriterien zu verwenden, und extrahieren sie direkt aus den Trainingsdaten. Dieser Prozess der Identifizierung intrinsischer Merkmale ist Teil der Modelltrainingsphase. Das Modell lernt dabei, Merkmale zu erkennen und entsprechende Vorhersagen zu treffen. In den folgenden Abschnitten beschreiben wir die Rolle der Regularisierung in diesem Prozess der Identifizierung intrinsischer Merkmale, wobei wir uns auf die L1-Regularisierung und ihre Bedeutung für die Verbesserung von Modellen des maschinellen Lernens konzentrieren.
Normalisierung und Modellkomplexität: Erweiterte Strategien zur Leistungsverbesserung
Bei der Regularisierung wird die Modellkomplexität bestraft, um eine Überanpassung zu vermeiden und eine Generalisierung der Aufgabe zu erreichen.
Die Komplexität des Modells entspricht hier seiner Fähigkeit, sich an Muster in den Trainingsdaten anzupassen. Angenommen, wir haben ein einfaches Polynommodell in x vom Grad d : Je höher der Grad d des Polynoms ist, desto flexibler kann das Modell Muster in den beobachteten Daten erfassen. Diese erhöhte Flexibilität kann dazu führen, dass das Modell die Trainingsdaten auswendig lernt, anstatt die tatsächlichen Muster zu erlernen, wodurch seine Fähigkeit zur Generalisierung auf neue Daten eingeschränkt wird.
Overfitting und Underfitting
Beim Versuch, ein Polynommodell vom Grad d = 2 an einen Trainingsdatensatz anzupassen, der aus einem Polynom dritten Grades mit Rauschen abgeleitet wurde, wird das Modell die Verteilung der Daten nicht adäquat abbilden. Dem Modell fehlt schlichtweg die Flexibilität und Komplexität , die zur Modellierung von Daten erforderlich sind, die durch Polynome dritten (oder höheren) Grades generiert werden. Man spricht von einer Unteranpassung des Modells an die Trainingsdaten. Unteranpassung bedeutet, dass das Modell zu simpel ist und die zugrundeliegenden Muster in den Daten nicht erfassen kann.
Nehmen wir an, wir haben ein Modell mit dem Grad d = 6. Mit zunehmender Komplexität sollte das Modell das ursprüngliche kubische Polynom, das zur Datengenerierung verwendet wurde, leicht schätzen können (z. B. durch Nullsetzen der Koeffizienten aller Terme mit Exponenten > 3). Wird der Trainingsprozess nicht rechtzeitig beendet, nutzt das Modell seine zusätzliche Flexibilität, um den Fehler weiter zu reduzieren, und beginnt, auch Rauschen zu erfassen. Dies reduziert zwar den Trainingsfehler deutlich, führt aber zu einer Überlastung des Modells mit Trainingsdaten. Das Rauschen ändert sich in realen Umgebungen (oder während des Testens), und jegliches auf Vorhersagen basierende Wissen wird dadurch beeinträchtigt, was einen hohen Testfehler zur Folge hat. Überlastung bedeutet, dass das Modell zu komplex ist und Rauschen anstelle des eigentlichen Signals lernt.
Wie bestimmt man die optimale Komplexität des Modells?
In der Praxis verfügen wir häufig nur über ein eingeschränktes oder gar kein Verständnis für den Prozess der Datengenerierung oder die tatsächliche Verteilung der Daten. Das optimale Modell mit der entsprechenden Komplexität zu finden, sodass es weder zu einer Unter- noch zu einer Überanpassung kommt, ist eine große Herausforderung. Dies erfordert den Einsatz effektiver Methoden zur Bewertung der Leistung von Modellen und zur Bestimmung der geeigneten Komplexität, die das beste Gleichgewicht zwischen Genauigkeit und Allgemeingültigkeit erreicht. Durch die Verwendung geeigneter Bewertungsmetriken und -techniken wie der Kreuzvalidierung können Fachleute das Modell ermitteln, das bei unbekannten Daten die beste Leistung erbringt, und so Über- oder Unteranpassungsprobleme vermeiden.
Eine mögliche Technik besteht darin, mit einem ausreichend robusten Modell zu beginnen und dann seine Komplexität durch Merkmalsauswahl zu reduzieren. Je weniger Merkmale, desto weniger komplex ist das Modell.
Wie wir im vorherigen Abschnitt besprochen haben, kann die Merkmalsauswahl explizit (Filtermethoden, Faltungsmethoden) oder implizit erfolgen. Redundante Merkmale, die für die Bestimmung des Werts der Zielvariablen nicht sehr wichtig sind, sollten entfernt werden, um zu vermeiden, dass das Modell darin unkorrelierte Muster lernt. Eine ähnliche Aufgabe wird auch durch die Regularisierung erfüllt. Welchen Zusammenhang gibt es also zwischen Regularisierung und Merkmalsauswahl, wenn es um das Erreichen des gemeinsamen Ziels einer optimalen Modellkomplexität geht? Die Reduzierung der Komplexität in Modellen des maschinellen Lernens ist entscheidend für die Verbesserung der Leistung und die Vermeidung von Überanpassung. Darauf konzentrieren sich sowohl die Regularisierung als auch die Merkmalsauswahl.
L1-Regularisierung als Merkmalsdeterminante
In Fortführung unseres Polynommodells stellen wir es als Funktion von f dar, mit den Eingangsgrößen x , den Koeffizienten θ und dem Grad d.
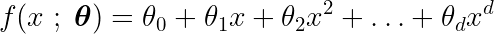
Beim Polynommodell kann jede Potenz des Eingangs x_i als Merkmal betrachtet werden, wodurch ein Vektor wie folgt gebildet wird:
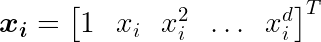
Wir definieren außerdem eine Zielfunktion, deren Reduktion zu den idealen Parametern θ* führt und die den Term Regularisierung enthält , der die Komplexität des Modells bestraft.
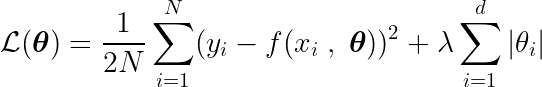
Um das Minimum dieser Funktion zu finden, müssen wir alle kritischen Punkte analysieren, d. h. die Punkte, an denen die Ableitung Null ist oder undefiniert ist.
Die partielle Ableitung nach einem der Parameter, θj , kann wie folgt geschrieben werden:
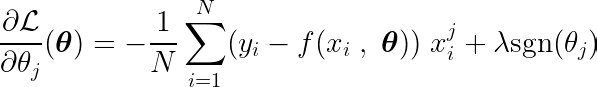
Die sgn- Funktion ist wie folgt definiert :
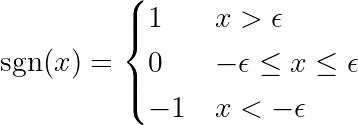
Hinweis : Die Ableitung einer Betragsfunktion unterscheidet sich von der oben definierten Vorzeichenfunktion (sgn). Die ursprüngliche Ableitung ist an der Stelle x = 0 nicht definiert. Wir erweitern die Definition, um den Wendepunkt bei x = 0 zu entfernen und die Funktion über ihren gesamten Definitionsbereich differenzierbar zu machen. Darüber hinaus verwenden Frameworks für maschinelles Lernen (ML) diese erweiterten Funktionen, wenn grundlegende arithmetische Operationen die Betragsfunktion beinhalten. Weitere Informationen finden Sie unter diesem Link im PyTorch-Forum.
Durch die Berechnung der partiellen Ableitung der Zielfunktion nach einem einzigen Koeffizienten θj und deren Nullsetzung können wir eine Gleichung konstruieren, die den optimalen Wert von θj mit Vorhersagen, Zielen und Merkmalen in Beziehung setzt.
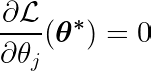
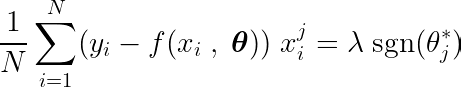
Betrachten wir die obige Gleichung genauer. Wenn wir annehmen, dass die Eingangs- und Zielwerte um den Mittelwert zentriert waren (d. h., dass die Daten im Vorverarbeitungsschritt standardisiert wurden), dann repräsentiert der Term auf der linken Seite (LHS) effektiv die Varianz zwischen Merkmal Nummer j und der Differenz zwischen den erwarteten und den Zielwerten.
Die statistische Kovarianz zwischen zwei Variablen bestimmt den Einfluss, den eine Variable auf den Wert der zweiten Variable hat (und umgekehrt).
Die Vorzeichenfunktion auf der rechten Seite zwingt die Varianz auf der linken Seite dazu, nur drei Werte anzunehmen (da die Vorzeichenfunktion nur -1, 0 und 1 zurückgibt). Ist das Merkmal j unnötig und beeinflusst es die Vorhersagen nicht, ist die Varianz nahe null, wodurch der entsprechende Koeffizient θj* null wird. Dies führt dazu, dass das Merkmal aus dem Modell entfernt wird. Dieser Prozess trägt zur Reduzierung der Komplexität und zur Verbesserung der Modellleistung bei.
Stellen Sie sich die Funktion des Zeichens als eine vom Wasser geformte Rille vor. Sie können in die Schlucht (also das Flussbett) hineingehen, aber um wieder herauszukommen, müssen Sie auf riesige Hindernisse oder steile Stromschnellen stoßen. Die L1-Regularisierung erzeugt einen „Schwellenwert“-Effekt, der dem Gradienten der Verlustfunktion ähnelt. Der Gradient muss stark genug sein, um die Barrieren zu durchbrechen oder Null zu werden, sodass der Koeffizientenwert schließlich Null wird.
Um ein realistischeres Beispiel zu liefern, betrachten Sie einen Datensatz, der Stichproben enthält, die aus einer geraden Linie (zweifaktoriell parametrisiert) mit etwas zusätzlichem Rauschen abgeleitet wurden. Das optimale Modell sollte nicht mehr als zwei Parameter haben, da es sonst zu einer Überanpassung an das Rauschen in den Daten kommt (mit der zusätzlichen Freiheit/Leistung des Polynoms). Das Ändern der höheren Leistungskoeffizienten in einem Polynommodell wirkt sich nicht auf den Unterschied zwischen den Zielen und den Modellvorhersagen aus und verringert somit deren Varianz mit dem Merkmal.
Während des Trainingsprozesses wird ein fester Schritt zum Gradienten der Verlustfunktion hinzugefügt/abgezogen. Wenn der Gradient der Verlustfunktion (MSE – mittlerer quadratischer Fehler) kleiner als die konstante Schrittweite ist, erreicht der Koeffizient schließlich den Wert 0. Beachten Sie die folgende Gleichung, die zeigt, wie die Koeffizienten mithilfe des Gradientenabstiegs aktualisiert werden:

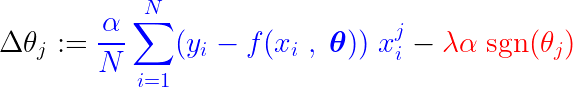
Ist der blaue Teil oben kleiner als λα , welches selbst eine sehr kleine Zahl ist, so ist Δθj annähernd ein konstanter Schritt von λα . Das Vorzeichen dieses Schritts (der rote Teil) hängt von sgn(θj) ab, dessen Ausgabe von θj abhängt . Ist der Wert von θj positiv, d. h. größer als ε , so ist sgn(θj) gleich 1, wodurch Δθj annähernd gleich -λα wird und somit gegen Null strebt.
Um den konstanten Schritt (roter Teil) zu unterdrücken, der den Koeffizienten auf Null setzt, muss der Gradient der Verlustfunktion (blauer Teil) größer als die Schrittweite sein. Um einen größeren Gradienten für die Verlustfunktion zu erhalten, sollte der Merkmalswert die Modellausgabe erheblich beeinflussen.
Auf diese Weise wird das Merkmal oder genauer gesagt der entsprechende Parameter, dessen Wert nicht mit der Modellausgabe zusammenhängt, während des Trainings durch die L1-Regularisierung auf Null gesetzt.
Weiterführende Literatur und Fazit
- Um mehr Einblicke in dieses Thema zu erhalten, habe ich eine Frage auf dem Reddit r/MachineLearning gepostet, undNachverfolgen Es enthält verschiedene Interpretationen, die Sie vielleicht lesen möchten.
- Madiyar Aitbayev hat auch interessanter Blog Behandelt dieselbe Frage, jedoch mit einer technischen Erklärung.
- Blog Brian King erklärt Organisation aus einer probabilistischen Perspektive.
- Dies Diskussion Auf der CrossValidated-Website erklärt er, warum das L1-Kriterium spärliche Modelle fördert. Blog In einem ausführlichen Artikel von Mukul Ranjan wird erklärt, warum die L1-Norm dazu ermutigt, Transaktionen auf Null zu reduzieren, die L2-Norm jedoch nicht.
„L1-Regularisierung wählt Merkmale aus“ ist eine einfache Aussage, der die meisten ML-Anwender zustimmen, ohne sich näher mit ihrer Funktionsweise zu befassen. Dieser Blogbeitrag soll mein Verständnis und mein Denkmodell mit Ihnen teilen, um diese Frage intuitiv zu beantworten. Für Anregungen und Fragen finden Sie meine E-Mail-Adresse auf meiner Website . Lernen Sie weiter und haben Sie einen schönen Tag!

Kommentarfunktion ist geschlossen.